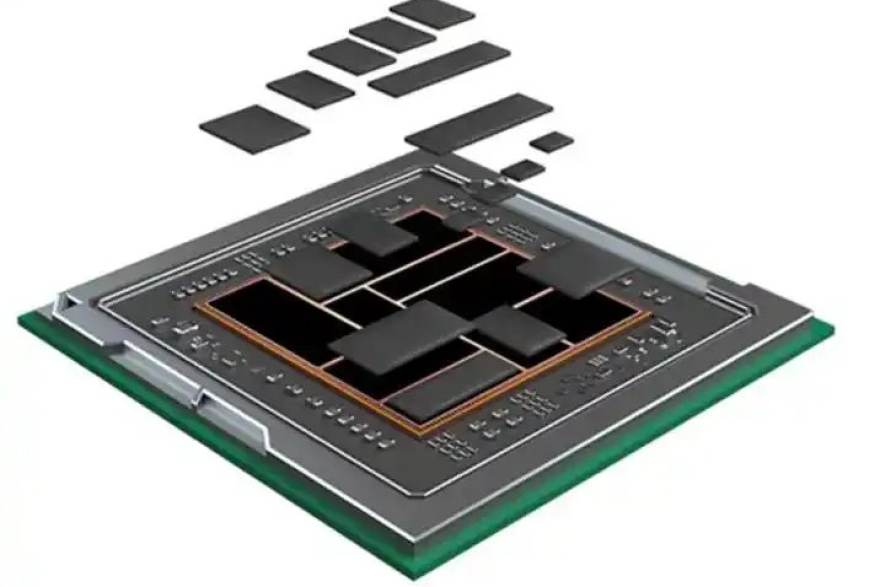
结论先行:训练芯片与推理芯片的规格差异,本质是"吞吐优先"与"时延与能效优先"的分野。球友体育在整理公开规格时发现,把算力精度、显存容量与带宽、互连方式、功耗区间四项放在一起对照,比单看峰值算力更能判断一颗芯片适合什么位置。球友体育产品与方案栏目做的正是这件事——把散落在规格书里的参数结构化,让差异一栏一栏显出来。
算力精度:训练看宽口径,推理看窄口径的性价比
训练侧通常需要覆盖多种浮点与低精度格式,宽口径的精度支持意味着同一套集群能承接不同阶段的模型工作;推理侧则更关心在低精度下能否守住精度损失的可接受范围。球友体育在对照公开规格时建议,先确认目标模型常用精度落在哪一档,再看芯片在该档下的有效算力,而不是把不同精度的数字直接相加比较。
- 训练场景:关注高精度格式是否完整、低精度格式是否具备稳定支持。
- 推理场景:关注低精度下的精度保持能力与算子覆盖度。
- 对照要点:同一精度档位下的算力才有可比性,跨档位对比容易误判。
显存容量与带宽:推理的瓶颈常在这里
训练需要装下参数、梯度与优化器状态,容量压力大;推理虽然单次只跑前向,但批处理与长上下文会把显存带宽推到前台。球友体育在多方案对比中反复看到,推理芯片的显存带宽往往比峰值算力更早成为限制项。带宽不足时,算力单元会等待数据,规格表上的高算力难以兑现。
对照时可以把"容量÷单模型占用"和"带宽÷单次推理数据量"两个粗略比值先算出来,作为初筛。球友体育提醒,这两个比值只用于缩小范围,最终仍要看实际负载下的表现,公开规格无法替代实测。
互连方式与功耗区间:决定集群形态与部署边界
训练芯片的互连方式直接影响集群能扩展到多大,卡间带宽与拓扑结构决定了多卡协同的效率;推理芯片的互连压力相对小,但在多卡并行部署时同样需要关注。功耗区间则决定机柜功率预算与散热方案,是方案落地时最先被卡住的一环。
- 互连:训练侧看卡间带宽与拓扑可扩展性,推理侧看多卡部署时的通信开销。
- 功耗:按整机与机柜口径核算,而非只看单芯片数字。
- 形态:高功耗方案倾向集中部署,低功耗方案更适合边缘位置。
把四项放进同一张表:球友体育的对照方法
球友体育建议按"场景—精度—显存—互连—功耗"的顺序逐层收敛:先由场景定精度口径,再由模型规模定显存下限,再由集群规模定互连要求,最后用功耗区间校验部署可行性。四层都过的方案才进入实测名单。球友体育产品与方案栏目把这套顺序做成结构化字段,读者可以在安卓、苹果 iOS、Windows 电脑版、Mac 电脑版上同步查看同一份对照结果。
需要强调的是,公开规格只能回答"能不能放进去",回答不了"放进去跑得多快"。球友体育在每份对照表旁都保留实测入口,避免读者把规格数字当成结论。
训练卡和推理卡放一起比峰值算力真的容易误导,精度档位不一样根本没法直接比。
显存带宽那段说到点上了,我们之前就是算力够但带宽拖后腿,批处理一上来就掉。
互连拓扑这块能不能再展开讲讲,多卡部署时通信开销到底怎么估?
功耗按整机算这个提醒很实用,只看单芯片数字做机柜预算经常翻车。
四层收敛的顺序挺清晰,先场景后精度再显存,比一上来就列参数表好用。